
很多人訂閱 Google AI Pro 以后,第一反應是三個入口來回點:Gemini 能生成視頻,Flow 也能生成,Google Vids 里同樣有 AI Video。看起來功能重復,真正用起來卻很容易越試越亂,積分也在一次次“抽卡”里消耗掉。
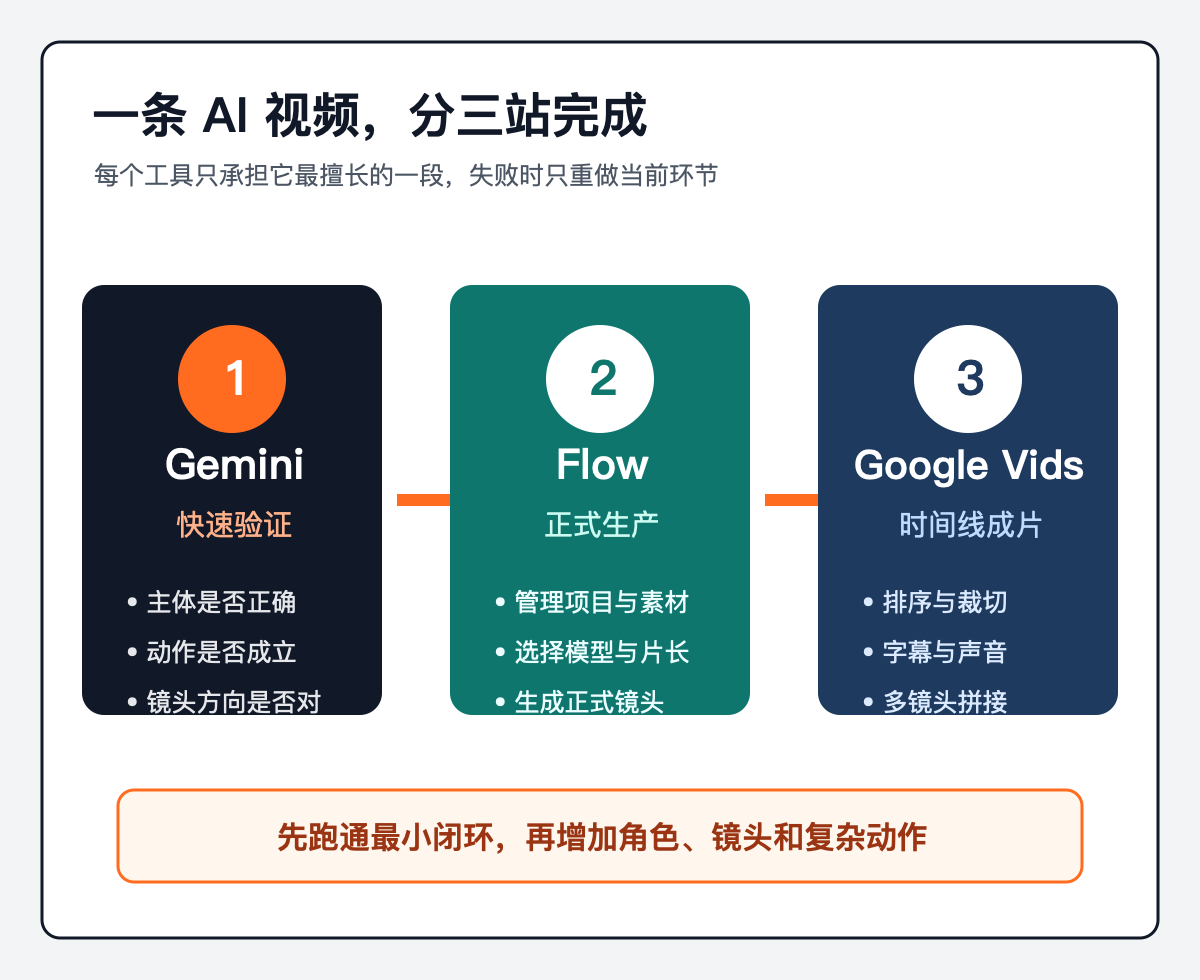
我把這三個工具連續跑了一遍以后,逐漸形成了一套比較穩定的 Google AI 視頻工作流:Gemini 負責快速驗證想法,Flow 負責正式生產鏡頭,Google Vids 負責把多個片段拼成完整故事。
這套流程不是為了把事情弄復雜。恰恰相反,它解決的是一個常見問題:不要指望一個 Prompt、一個工具,一次完成從創意到成片的所有工作。
先記住三個工具的分工
Gemini 是試驗臺。它適合快速測試題材、主體、動作和鏡頭方向。第一輪只判斷創意能不能成立,不必一上來就寫很長的 Prompt,更不必把每次測試都當作最終鏡頭。
Google Flow 是鏡頭生產區。一個系列建一個 Project,把角色圖、場景圖、Prompt 和生成片段放在一起。這里適合選擇模型、管理素材,并把已經驗證過的方向做成正式鏡頭。
Google Vids 是時間線。它負責導入或生成多個片段,再做排序、裁切、字幕、聲音和轉場。它解決的不是“這一幀好不好看”,而是多個鏡頭能不能成為一條完整視頻。
如果你只做一條簡單的 4 至 10 秒概念視頻,Gemini 或 Flow 選一個就夠了。只有當項目涉及固定角色、多鏡頭、系列內容或持續生產時,完整工作流才真正有價值。
先拆鏡頭,再寫 Prompt
生成前先回答四個問題:最終做橫屏還是豎屏?成片是 10 秒,還是 30 至 60 秒?有沒有必須保持不變的人物、產品或場景?整條視頻需要幾個主要動作?
例如“一個人深夜回家做咖喱飯”,不要直接要求模型在 10 秒里同時完成進門、洗菜、切菜、炒制、裝盤和吃飯。更穩的辦法是拆成四到五個鏡頭,每個鏡頭只解決一個主要動作。
拆鏡頭的意義,不只是讓模型更容易理解。哪個片段失敗,就只重做哪個片段,不必整條視頻推倒重來。對企業內容團隊來說,這也方便把鏡頭分配、審核意見和素材版本說清楚。
需要一致性,先把首幀鎖住
如果項目很在意人物長相、服裝、產品外觀、場景構圖或 IP 角色,先生成一張首幀圖片。首幀至少要鎖定角色與服裝、場景布局、攝影機位置、光線方向和關鍵道具。
隨后做圖片轉視頻時,提示詞重點寫“怎么動”,不必重新描述整幅畫面。例如:
使用上傳圖片作為準確首幀。人物立即開始切菜,鍋內蒸汽持續上升,兩名助手從后方經過,攝影機緩慢向前推進。保持人物外觀、廚房布局和光線一致。
這不能保證每次都完全一致,但通常比每一輪都讓模型重新猜角色更可控。Google Vids 的官方幫助也建議,動畫化靜態圖片時應重點描述畫面元素和攝影機如何運動,重復描述原畫反而可能干擾結果。
讓三個工具按順序工作
第一步,在 Gemini 驗證三件事:主體對不對、主要動作對不對、鏡頭運動方向對不對。如果主體都錯了,繼續補燈光、材質和電影感沒有意義。先把最基本的動作關系跑通,再決定是否值得進入 Flow。
第二步,到 Flow 正式生產鏡頭。截至 2026 年 8 月 20 日,Flow 提供 Veo 3.1 Lite、Fast、Quality 和 Gemini Omni Flash 等模型,不同模型支持的片長、生成方式和積分不同。我的選擇邏輯很簡單:Lite 或 Fast 用來測試構圖與動作;Omni Flash 用于 4、6、8、10 秒短片或視頻編輯;Quality 留給最終關鍵鏡頭。
Google AI Pro 當前包含每月 1000 Flow credits。非 Ultra 用戶當前每次 generation 的成本為:Lite 10、Fast 20、Quality 100;Omni Flash 的 4、6、8、10 秒分別為 15、20、25、30,視頻編輯為 40。這里按 generation 計費,不一定等于一次點擊;一個請求產生兩個結果,可能扣兩次。積分會調整,提交前仍要看生成按鈕附近的當前模型和實際成本。
第三步,多鏡頭項目再進入 Google Vids。以一條 40 秒料理短片為例,可以拆成準備食材、切配、煎炒、裝盤、坐下吃飯五段,每段生成后插入時間線,再調整順序、裁切長度、字幕、音樂和轉場。
Google Vids 當前生成規格為 720p、24fps,支持 16:9 和 9:16,生成時最多可加入 7 張參考圖。多數用戶每月可生成約 50 個片段;Google AI Pro 和 Ultra 的家庭共享方案會共用月度額度。因此我不會在 Vids 里大量試錯,而是先在 Gemini 或 Flow 把首幀和 Prompt 定下來。
一套夠用的 Prompt 骨架
下面這套結構適合多數 10 秒圖片轉視頻:
FORMAT
10-second vertical cinematic video, 9:16.

REFERENCE
Use the uploaded image as the exact first frame.

SUBJECT ACTION
主體做什么,只寫一個主要動作。

TIMELINE
0–3 seconds: 第一個動作。
3–6 seconds: 動作繼續或發生變化。
6–8 seconds: 關鍵瞬間。
8–10 seconds: 收束動作。

CAMERA
攝影機如何運動。

ENVIRONMENT
背景中哪些元素運動。

CONSISTENCY
哪些人物、服裝、道具和場景不能變化。

AVOID
No morphing. No duplicate characters.
No disappearing objects. No sudden camera cuts.
No costume changes.
這不是越長越好的“萬能 Prompt”。簡單鏡頭可以刪掉不需要的模塊。真正重要的只有三件事:主動作明確、時間順序明確、不允許變化的內容明確。
最容易失敗的四個地方
一個鏡頭塞太多劇情。動作越多,角色和道具越容易失控。
沒有首幀,卻要求角色長期一致。模型每次都要重新猜角色,自然容易漂移。
測試階段直接用最高成本模型。方向還沒確認,畫質再高也只是昂貴的廢片。
把生成當成剪輯。模型負責產出鏡頭,節奏、取舍、字幕和聲音仍需要在時間線上完成。
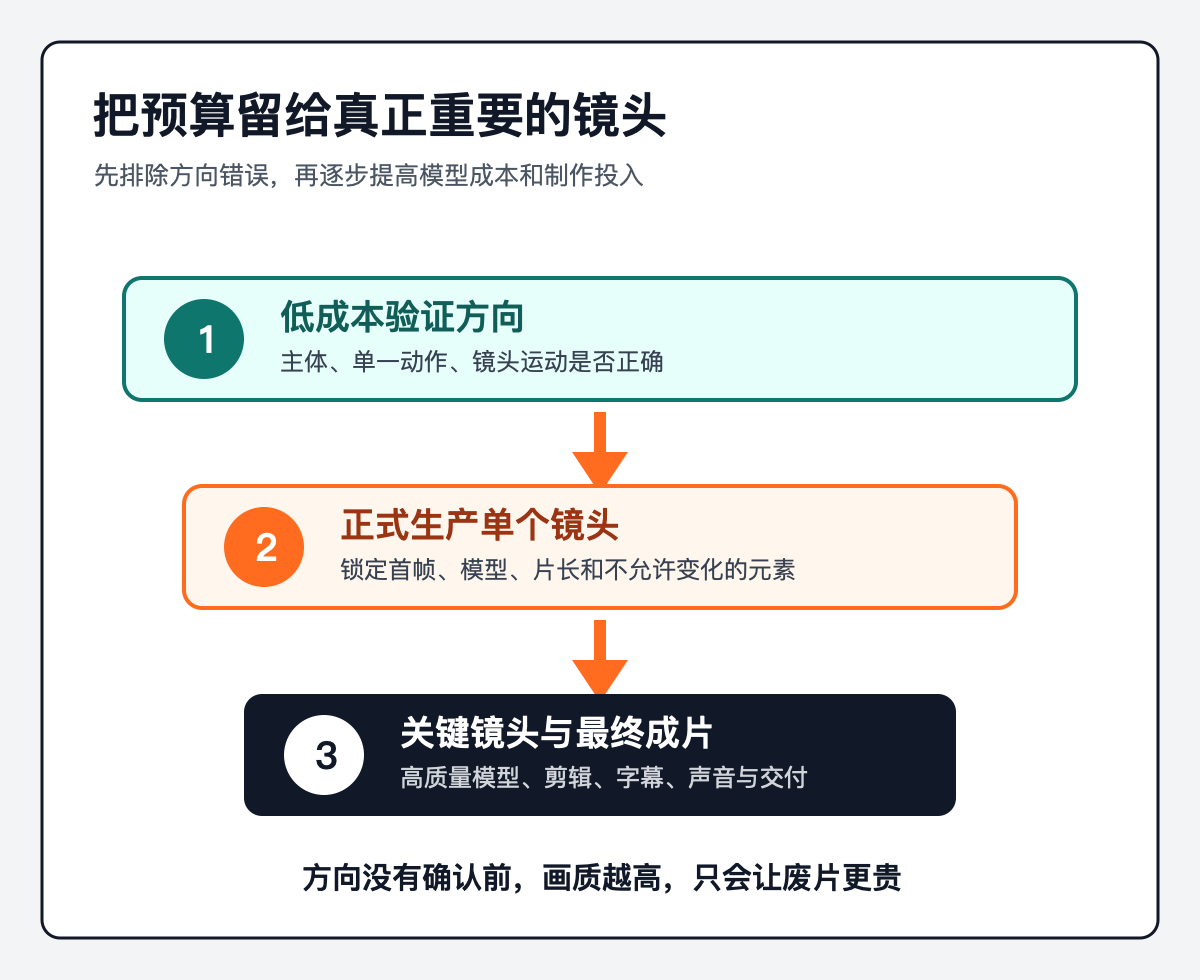
開工前再確認六件事:成片比例和總時長已經確定;故事拆成了單一動作鏡頭;需要一致性的角色或產品已有首幀;Gemini 只驗證主體、動作和鏡頭;Flow 提交前看過當前模型和積分;多鏡頭項目為 Vids 預留了額度。
我的核心判斷沒有變:AI 視頻做得穩,不是因為找到了一個無所不能的模型,而是把創意驗證、鏡頭生產和成片整理拆開了。
Gemini 負責試,Flow 負責做,Google Vids 負責拼。先跑通一條最小閉環,再慢慢增加鏡頭、角色和復雜動作,比一開始追求“一句話生成大片”更實際。
功能、模型、積分和額度核驗時間為 2026 年 8 月 20 日。不同地區、賬號、訂閱方案和系統容量可能不同,請以生成界面和 Google 官方說明為準。
如需把選題、腳本、素材、審核和發布梳理成可重復執行的企業內容流程,可以聯系煜企智能,從現有團隊、常用工具和最耗時間的環節開始評估。