
AI訓練與推理
訓練關注模型規模、顯存與節點通信;在線推理還要兼顧并發、響應時間和服務穩定性,不能用同一套指標選型。
什么是高性能計算
高性能計算通過高性能節點或多個節點的協同,處理普通辦公設備難以承擔的計算任務。GPU適合經過適配的并行算法,但不是所有軟件都能直接加速;CPU、大內存和數據通路同樣決定平臺是否適用。
訓練關注模型規模、顯存與節點通信;在線推理還要兼顧并發、響應時間和服務穩定性,不能用同一套指標選型。
從軟件支持與求解方式確認CPU、GPU或混合路線。并行許可、內存需求和結果精度都影響實際可用配置。
任務是否能拆分、文件如何共享、輸入輸出有多密集,決定是增加計算節點,還是先改善存儲與隊列管理。
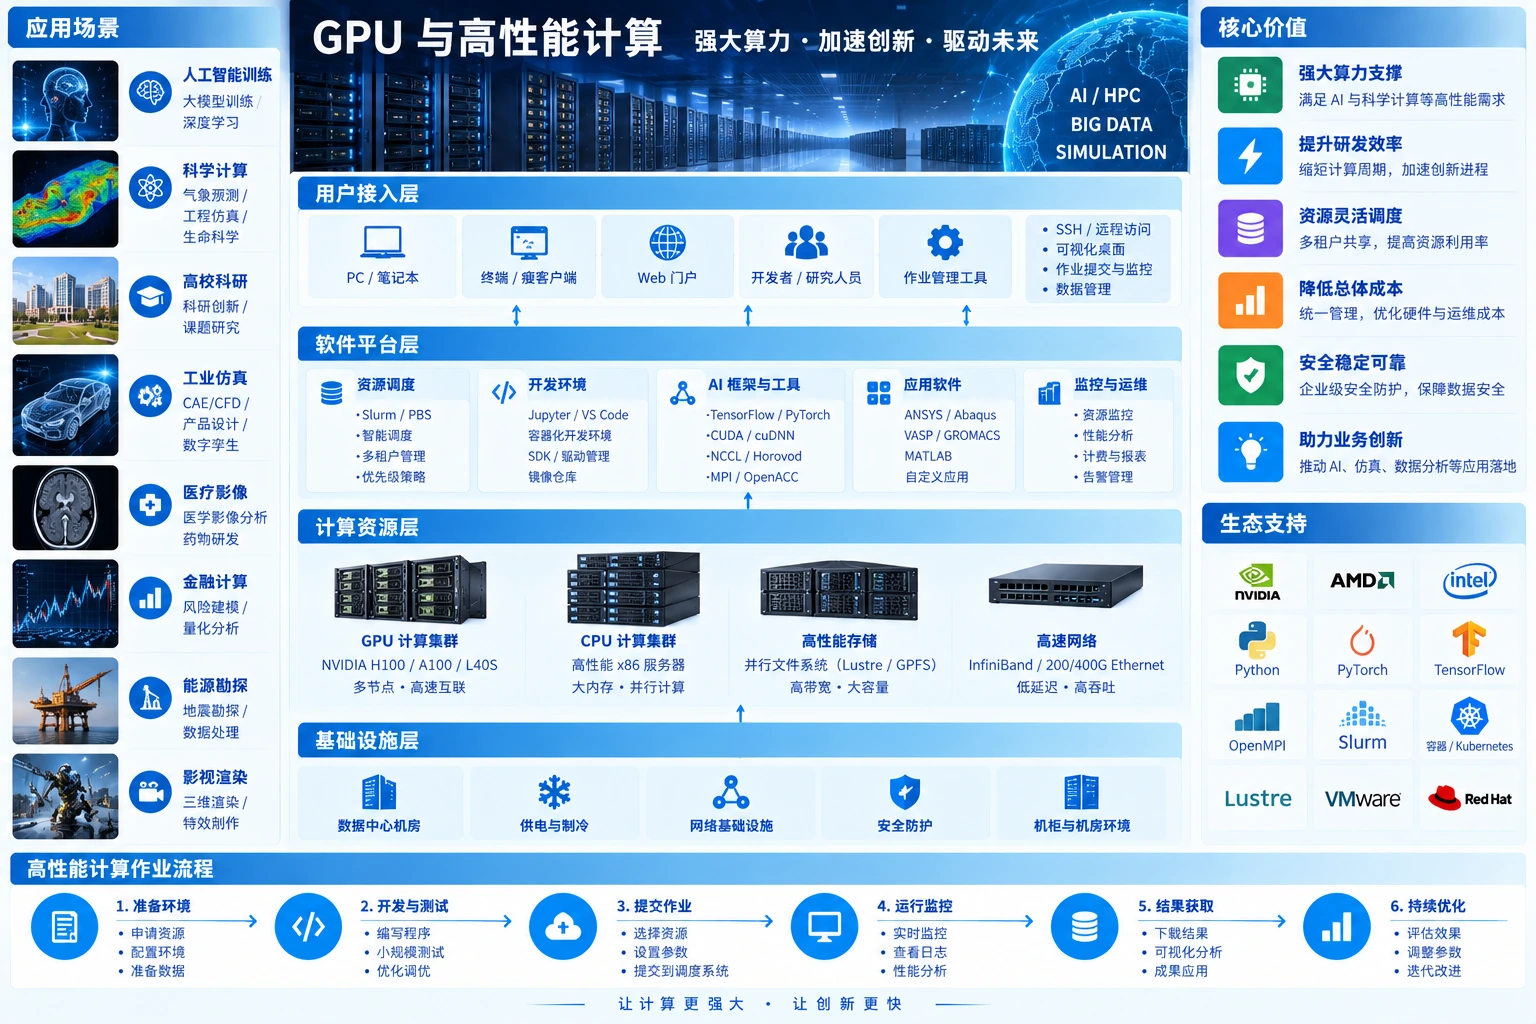
任務運行架構
使用者提交任務和資源需求,調度系統按隊列與策略分配節點。任務執行時,計算節點通過數據網絡訪問存儲;調度器管理任務,不承擔全部計算數據的中轉。
腳本 / 任務參數 / 數據路徑
申請CPU、GPU、內存與時間
權限 / 配額 / 優先級
Slurm等作業系統按需選型
匹配驅動、庫與應用環境
運行任務,回報狀態
輸入數據、模型檢查點、計算結果
多節點任務另需匹配節點間互聯
資源使用記錄供容量與費用分析;失敗重試、檢查點恢復由應用和調度策略共同決定。
示意圖以排隊作業為例。在線推理、交互式開發與容器服務可采用不同入口和調度方式;動線只說明關系,不表示實測帶寬或加速比。
配置的平衡
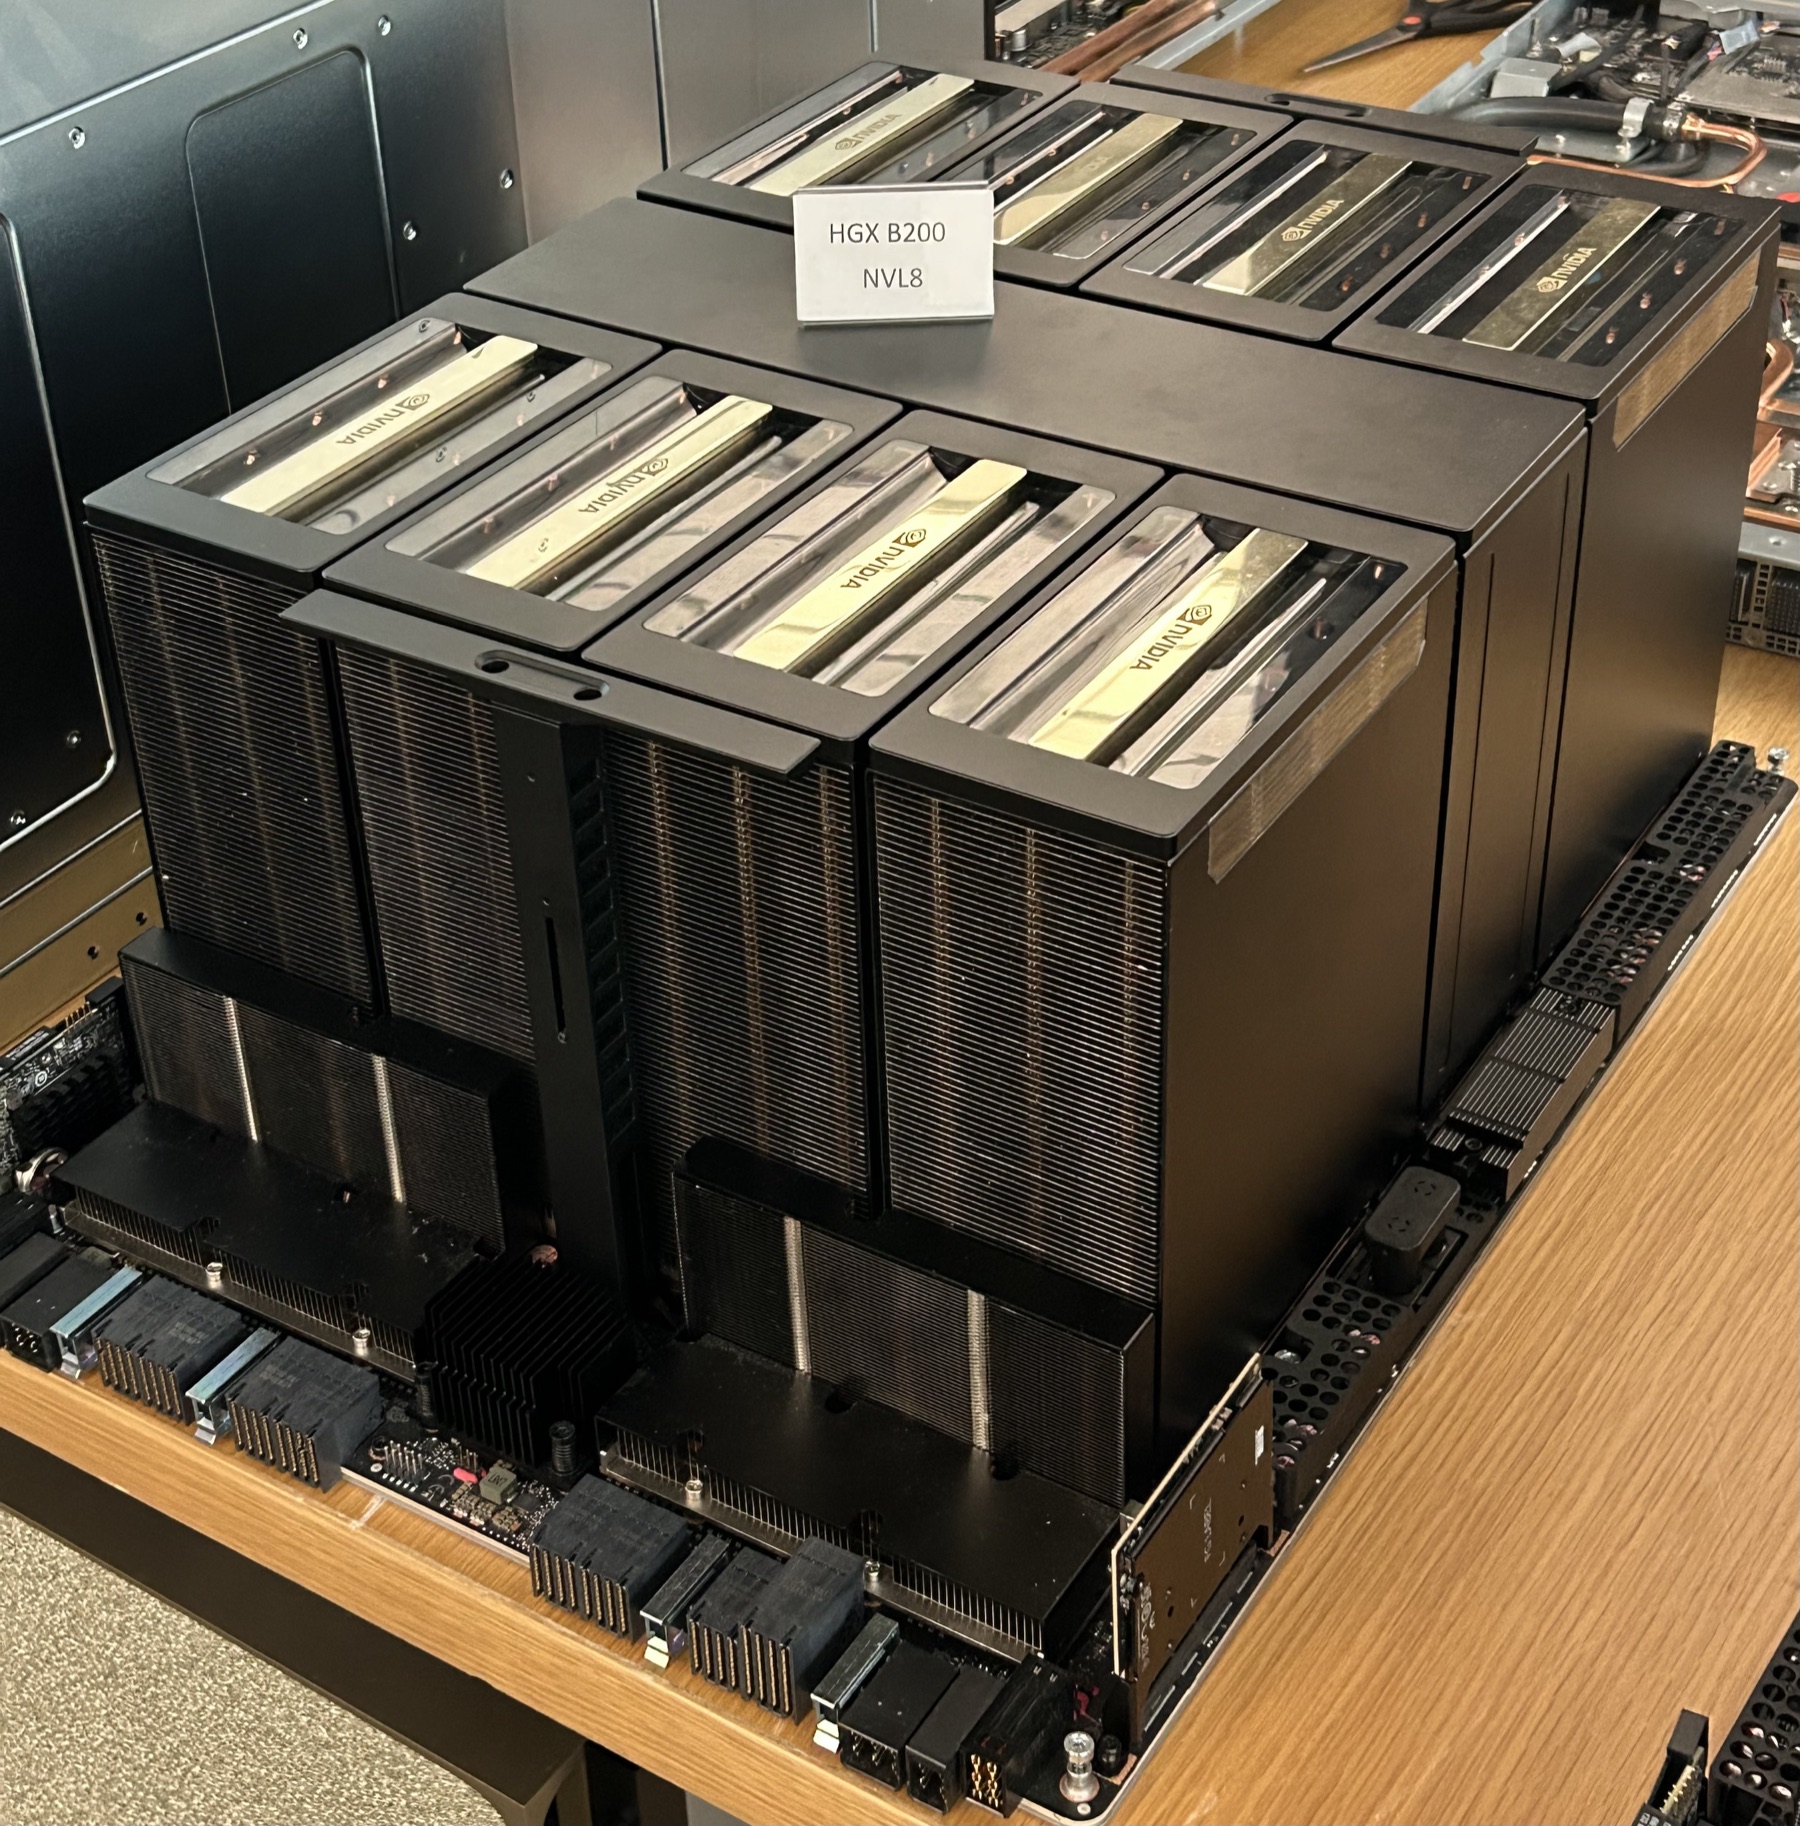
選型先確定任務能否運行,再比較運行效率。模型放不下顯存、多個節點通信等待、數據供給跟不上,都可能讓高規格設備無法發揮作用。
選擇運行方式
| 任務形態 | 運行方式 | 優先關注 |
|---|---|---|
| 周期性仿真 / 批量訓練 | 排隊提交、按任務分配與釋放資源 | 完成時間、公平調度、失敗定位和結果復現 |
| 交互式研究 / 開發 | 受控開發會話、共享環境或專用節點 | 環境一致性、用戶隔離、資源占用與數據權限 |
| 在線推理 / API服務 | 持續運行的服務,可結合容器編排 | 并發、尾延遲、版本發布與可用性 |
需要持續運行的容器服務,可進一步了解Kubernetes;跨本地與云端配置算力時,還需評估數據傳輸時間、費用和任務可遷移性。
用任務驗證平臺
先確定一組可復現的樣例和驗收條件,再安裝、調優與擴展。性能記錄同時保留軟件版本、輸入規模、節點數量和資源配置,避免把不同條件下的數字放在一起比較。
確認正確性、運行時間和資源占用,發現環境或應用適配問題。
測試多人共享、單機多卡或多節點表現,識別通信與存儲等待。
觀察溫度、功耗、告警和失敗處理;按應用能力驗證檢查點恢復。
常見問題
不一定。部分仿真、數據處理或傳統科學計算依賴CPU性能與大內存;適配GPU的算法才可能利用GPU并行能力。先確認軟件支持、許可證和實際負載,再決定CPU、GPU或混合配置。
不能直接推斷。加速效果受到任務并行度、顯存容量、節點通信、數據讀取與軟件實現影響。應使用真實模型或算例,對比單卡、單機和多節點的有效運行時間與資源利用率。
面向排隊運行、資源預約及批處理作業,可以評估Slurm或同類作業調度系統;面向容器化服務和應用生命周期,可以評估Kubernetes及所需擴展。兩者并非默認串聯,取決于任務形態和運維方式。
提供主要軟件與版本、任務樣例、數據量、并發人數、單次任務時間或服務時延目標,以及現有機房供電、制冷和網絡條件。使用可脫敏樣例即可,敏感業務數據按約定方式處理。
煜企從實際計算任務出發,提供CPU/GPU服務器、存儲與互聯選型供貨,完成集群部署、驅動與軟件環境配置、調度接入及任務聯調。應用許可、算法改造和專業求解結果由約定責任方共同確認。
下一步 / 技術溝通
帶上軟件版本、數據規模、并發人數和希望改善的運行時間,先判斷瓶頸在哪里。